Distribuidor Faz Parte Do Sistema

Entendendo o papel do distribuidor em sistemas distribuídos
A gente ouve muito sobre arquitetura distribuída, microserviços, filas de mensagem e esse tipo de coisa. O que pouca gente explica direito é o componente mais simples e mais importante: o distribuidor. É basicamente o cara que recebe uma requisição ou mensagem e decide pra onde ela vai. Pode parecer bobo, mas é onde a maioria dos problemas começa. Um distribuidor é um componente que centraliza o roteamento de tráfego dentro de uma rede ou aplicação. Ele pode ser um load balancer, um message broker, um sidecar proxy, ou até um módulo de software rodando junto com a aplicação principal. A escolha do distribuidor depende completamente do contexto. Não existe solução única que funcione bem em todos os cenários. No meu caso, eu já vi desde um Nginx configurado em frente a um cluster de containers Kubernetes até um serviço customizado escrito em Go que fazia routing baseado no payload da mensagem. Ambos funcionaram. Ambos também causaram dor de cabeça em momentos diferentes. O distribuidor é parte do sistema operacional da aplicação, não um acessório opcional.
Como o distribuidor funciona na prática
O funcionamento básico envolve três etapas: receber, decidir, encaminhar. Você tem uma entrada, um mecanismo de decisão e uma saída para um ou mais destinations. A complexidade aparece nos detalhes. O algoritmo de decisão pode ser round-robin, least-connections, weight-based, hash-based, ou algo customizado. Cada um tem implicações diferentes. Round-robin é simples mas ignora o estado real dos destinos. Least-connections funciona melhor quando os tempos de resposta variam muito entre instâncias. Weight-based exige manutenção manual constante. Hash-based garante sticky sessions mas pode gerar distribuição desigual se o de chaves for pequeno. Eu configurei um distribuidor com hash-consistent para um sistema de processamento de eventos. A ideia era garantir que mensagens do mesmo usuário sempre fossem para a mesma instância, evitando state sharing. Funcionou bem até eu perceber que o cardinality do hash space era baixo demais. Cerca de 30% das mensagens iam para apenas 4 dos 20 nós. A correção foi aumentar o número de buckets virtuais de 100 para 500 e redistribuir o tráfego. Isso resolveu, mas levou duas horas de debugging porque o log do distribuidor não mostrava a distribuição real.
Distribuidor faz parte do sistema: aspectos técnicos críticos
O ponto que os tutoriais geralmente pulam é o single point of failure. Se o distribuidor cair, tudo cai. Isso parece óbvio, mas na prática muita gente esquece de provisionar alta disponibilidade para o próprio componente que gerencia a resiliência do sistema. Recomendo pelo menos dois nós do distribuidor em active-active ou active-passive, dependendo do protocolo. Para HTTP/HTTPS com Nginx ou HAProxy, o pattern active-passive com keepalived funciona bem. Para serviços service mesh como Envoy ou Linkerd, o pattern é naturalmente active-active porque cada sidecar é um distribuidor local. Outro aspecto negligenciado é o health checking. Um distribuidor que não verifica se o destino está vivo antes de enviar tráfego vai gerar timeouts e retries desnecessários. A maioria dos load balancers modernos suporta health checks ativos com probe HTTP, TCP ou gRPC. Configure health checks agressivos nos primeiros dias para detectar problemas cedo. Depois de estabilizado, reduza a frequência para evitar overhead.

Também é importante monitorar o tempo de decisão do distribuidor. Em sistemas de alta latência crítica, cada milissegundo de processamento no distribuidor conta. Eu trabalhei em um projeto onde o distribuidor estava adicionando 15ms de latência em média devido a configurações de timeout mal ajustadas. Ajustamos os timeouts de conexão de 5 segundos para 500ms e habilitamos conexões persistidas. O resultado foi redução de 12ms de latência média e queda de 40% nos erros de timeout.
Pegadinhas comuns ao implementar um distribuidor
A primeira pegadinha é confundir distribuidor com gateway. O distribuidor roteia tráfego dentro do sistema. O gateway é a porta de entrada para o sistema. Muitas arquiteturas usam ambos, mas eles têm responsabilidades diferentes. O gateway cuida de autenticação, rate limiting, transformation. O distribuidor cuida de roteamento, balancing, retry logic. A segunda pegadinha é subestimar o impacto do DNS. Se o distribuidor resolve nomes DNS a cada requisição, você vai ter latência adicional e possível inconsistência de cache. Configure TTLs curtos no DNS se você precisar de failover rápido, mas tenha em mente que isso aumenta a carga no resolver. O equilíbrio ideal depende do SLA do sistema. A terceira pegadinha é não considerar a propagação de cache. Se o distribuidor mantém cache de respostas, dados desatualizados podem ser servidos durante switches de backend. Isso é especialmente problemático em sistemas financeiros ou de saúde onde a consistência é crítica. Desative cache no distribuidor se a consistência for mais importante que performance.
Quando não usar um distribuidor centralizado
Existem cenários onde um distribuidor centralizado é a escolha errada. Se você tem menos de cinco instâncias e o tráfego é previsível, um balanceamento simples via DNS round-robin pode ser suficiente. A complexidade de manter um distribuidor dedicado não justifica o benefício nesse caso. Se o sistema é predominantemente read-heavy com dados replicados em múltiplos datacenters, o padrão client-side routing pode ser mais eficiente. Cada cliente decide qual réplica contatar baseado na localização geográfica ou na latência medida. Isso elimina o ponto único de falha e reduz a latência de rede, mas transfere complexidade para cada cliente. Também considere a ausência de distribuidor se a aplicação já implementa algum tipo de balancing nativo. Bases de dados como Cassandra e MongoDB têm seus próprios mecanismos de routing. Adicionar um distribuidor na frente pode criar camadas desnecessárias de complexidade sem benefício proporcional.

Métricas essenciais para um distribuidor
Você precisa monitorar latency p50, p95 e p99. A média esconde problemas. Um distribuidor pode ter latência média de 5ms enquanto serve 10% das requisições com mais de 500ms devido a hot spots ou instâncias degradadas. Throughput por segundo também é importante, mas não basta olhar o total. Separe throughput por destino. Se um nó está recebendo muito mais tráfego que os outros, o algoritmo de balancing pode estar falho ou há um problema de conectividade com os destinos alternativos. O erro rate por código HTTP é fundamental. Erros 502, 503 e 504 indicam problemas nos destinos. Erros 4xx podem indicar configuração errada no distribuidor, como path matching incorreto ou header requirements ausentes.
Conexões ativas e taxa de rejeição completam o quadro. Se o distribuidor está rejeitando conexões frequentemente, você precisa aumentar o limite de conexões por processo ou distribuir a carga entre mais nós. No final das contas, o distribuidor é um componente simples que faz uma coisa básica muito bem: roteia tráfego. Mas simples não significa fácil. A implementação correta exige entendimento profundo do protocolo, do padrão de tráfego e dos requisitos de resiliência do sistema. Se você está construindo algo novo, gaste tempo analisando o que seu distribuidor precisa fazer antes de escolher a ferramenta. A escolha errada no início vai custar muito mais depois.
Galeria
-

Distribuidor Faz Parte Do Sistema - RETOEDU -

Distribuidor Faz Parte Do Sistema - RETOEDU -
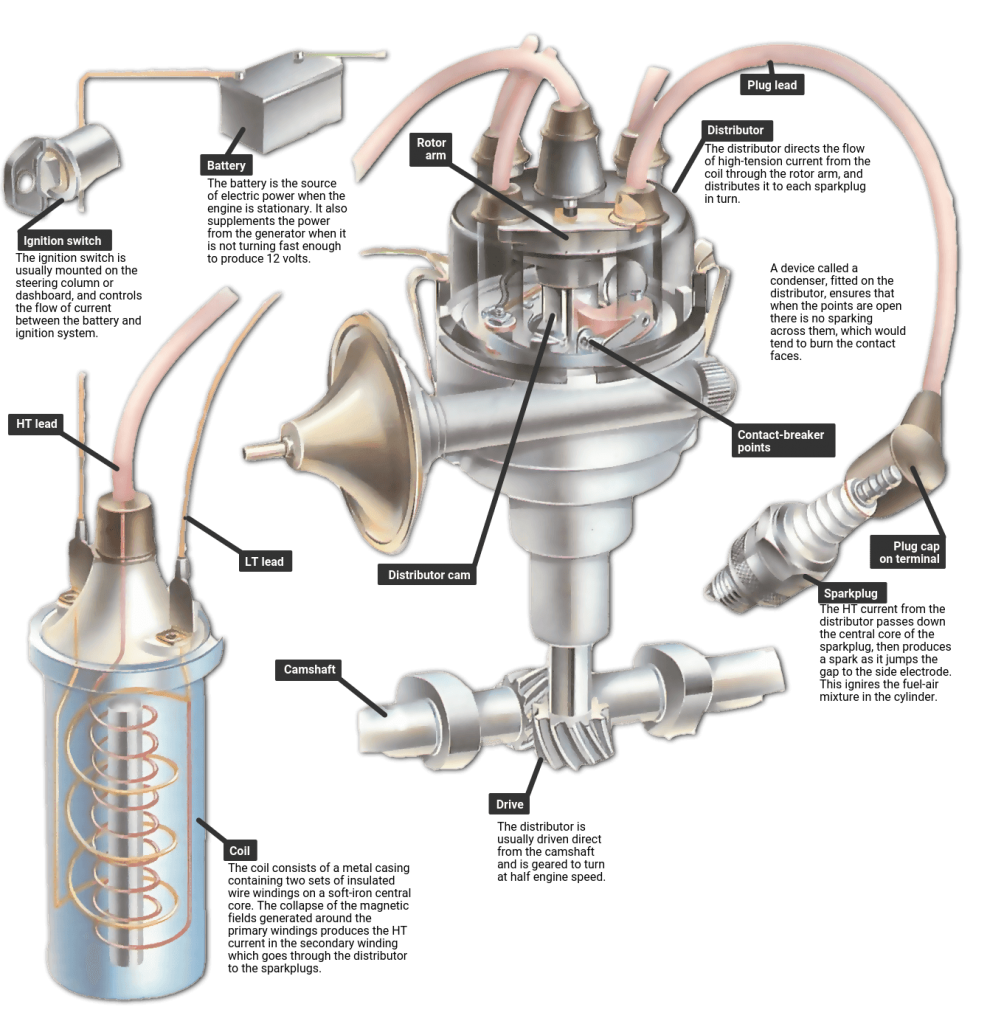
Partes Del Distribuidor | Las partes del sistema de encendido – DLYG
