Durante O Desenvolvimento De Um Software A Equipe Se Debruça

Quando a equipe precisa mergulhar fundo em um problema complexo
Existe um momento no ciclo de desenvolvimento em que a equipe se debruça sobre um problema que não cede para soluções rápidas. Isso não acontece todo dia, mas quando acontece, o custo de ignorar é bem maior do que o tempo gasto resolvendo. Vou explicar como isso funciona na prática, porque já vi time inteiro desperdiçar semanas com abordagem errada. A ideia central é simples: há situações em que o time precisa parar de codar e começar a pensar. Não é sobre fazer mais reuniões, é sobre trocar o ritmo. Quando um bug aparece esporadicamente, quando uma arquitetura nova mostra rachaduras nos testes de carga, quando o produto não consegue escalar de forma previsível — nesses casos, seguir em frente com desenvolvimento normal só empurra o problema para baixo do tapete. Na minha experiência, o sinal mais claro de que isso é necessário é quando duas pessoas do time chegam a conclusões diferentes sobre a mesma causa raiz, após investigações paralelas. Se o engenheiro A acha que é problema de concorrência e o engenheiro B jura que é configuração de infraestrutura, você tem um nó que precisa ser desatado em conjunto.
Eu tive um caso específico em que um serviço de pagamento apresentava falhas intermitentes apenas em produção. Os logs mostravam timeouts, mas o rate was dentro do esperado. Fiquei duas semanas tentando reproduzir localmente sem sucesso. A solução veio quando decidi parar de caçar o bug sozinho e chamar o time para uma sessão de imersão de três dias. Mapeamos juntos toda a cadeia de dependência, desde o gateway até o banco. Descobrimos que um serviço de cache intermediário tinha uma política de TTL configurada de forma inconsistente entre ambientes, o que causava leitura de dados obsoletos apenas sob determinadas condições de concorrência. O workaround foi padronizar o TTL com base em testes de consistência cross-environment antes de qualquer deploy. Economizamos cerca de quarenta horas de debugging em regime individual. O método que costuma funcionar é o seguinte. Primeiro, isole o problema. Não adianta debater se você ainda não sabe exatamente onde está a falha. Replique em ambiente controlado se possível. Segundo, documente o que você já descarta. Listar o que não é causa raiz economiza tempo futuro e evita que o time volte a testar hipóteses já refutadas. Terceiro, traga pessoas de áreas diferentes para a análise. Quem desenvolve a API não vê os mesmos padrões que quem opera a infraestrutura. A combinação de perspectivas reduz cegueira espacial. Um erro comum é transformar essa imersão em um evento único com data marcada no calendário. Às vezes, o problema exige uma série de sessões mais curtas, com intervalos para o cérebro processar. Meu time adotou o formato de blocos de quatro horas, com pausas obrigatórias, e a produtividade na análise aumentou significativamente comparado aos maratonas de oito horas que tínhamos antes.
Não existe software que resolva isso por você. Ferramentas de observabilidade ajudam, dashboards ajudam, mas a decisão crítica de quando pausar o fluxo normal e investir tempo em análise profunda é humana. E há cenários em que essa abordagem não funciona. Se o problema é falta de informação — um requisito mal documentado, uma decisão de negócio ambígua — o time se debruçando não vai resolver. Nesse caso, o correto é escalar para a parte interessada e trazer clareza antes de continuar. Também é importante saber quando desistir. Há casos em que o esforço para resolver um problema excede o valor que a resolução traz. Se um bug afeta menos de um por cento dos usuários e não impacta a integridade dos dados, às vezes a melhor decisão é registrar, monitorar e priorizar para outro momento. Nem tudo que parece urgente é importante.

Galeria
-

Os 5 erros mais comuns em Equipes de Desenvolvimento de Software ... -
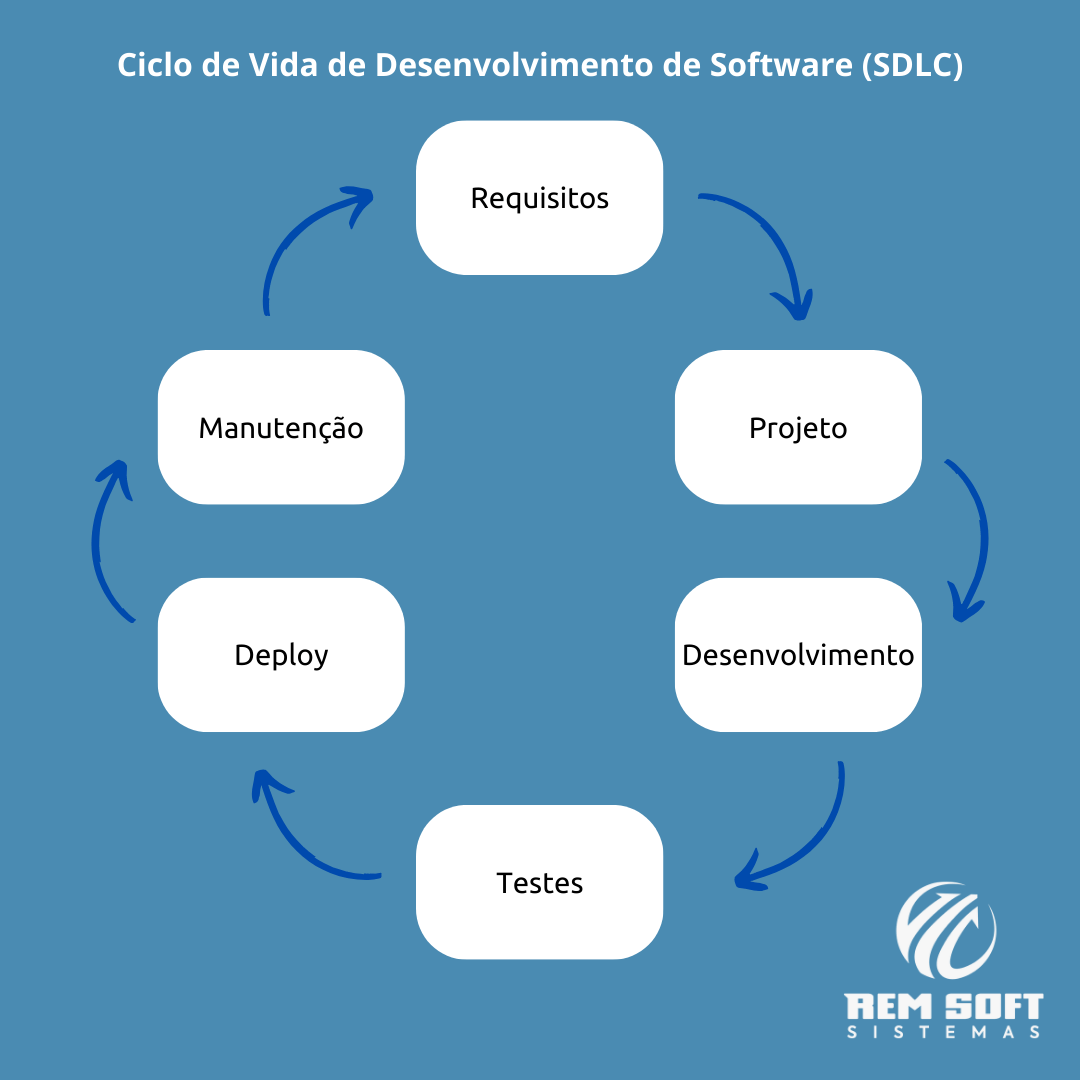
Conheça As Principais Etapas Para O Desenvolvimento De Software – PDZP -

Entenda o que é desenvolvimento de software e como funciona o processo ... -

Ciclo de vida do desenvolvimento de software: etapas e exemplos
