O Que Significa Junção
Junção em banco de dados: o que você realmente precisa saber
Junção é basicamente o ato de combinar linhas de duas ou mais tabelas com base em uma relação entre elas. No SQL, isso aparece como o comando JOIN. Simples assim na teoria. Na prática, eu já vi gente passar duas horas debugando um JOIN que retornava 50 mil linhas quando deveria retornar duzentas. Existem quatro tipos principais que você vai encontrar em qualquer banco relacional: INNER JOIN, LEFT (ou LEFT OUTER) JOIN, RIGHT (ou RIGHT OUTER) JOIN, e FULL OUTER JOIN. A diferença entre eles é só uma coisa: o que acontece com as linhas que não têm correspondência. No INNER JOIN, se não tiver par na outra tabela, a linha simplesmente some. Nunca aparece no resultado. No LEFT JOIN, todas as linhas da tabela da esquerda aparecem, e as colunas da direita vêm preenchidas com NULL quando não há match. O RIGHT JOIN faz o inverso, e o FULL traz tudo de ambos os lados, preenchendo NULL onde falta par.
Eu já perdi tempo conta que é muita coisa com LEFT JOINs que viravam cross joins acidentais por causa de condição mal colocada no WHERE. A clássica: você faz LEFT JOIN e depois filtra a tabela da direita no WHERE, e aí mágica, o LEFT vira INNER sem você perceber. A linha que não tinha correspondência é eliminada pela condição de filtro, e o resultado é completamente diferente do esperado.
Como as junções funcionam por dentro
O otimizador do banco escolhe um plano de execução para resolver o JOIN. Os algoritmos mais comuns são nested loop, hash join e merge join. Cada um tem um cenário onde brilha e um onde falha feio. Nested loop funciona bem quando uma das tabelas é pequena e tem índice na coluna de junção. Você itera sobre cada linha da tabela externa e procura na interna. Se a interna tem índice, é rápido. Se não tem, cada busca é uma varredura completa, e o custo explode de forma quadrática. Tabela de 1.000 linhas com 1 milhão de correspondentes pode levar segundos em vez de milissegundos. Hash join constrói uma tabela hash na memória com a tabela menor e depois faz probe nas linhas da maior. É robusto para tamanhos médios, mas se a tabela não couber na memória disponível, o banco faz spill para disco, e aí o desempenho cai numa velocidade que dói. Em produção, eu já vi hash join levar 4 minutos num servidor sobrecarregado e 8 segundos no mesmo query com carga normal. Variável demais.
Merge join exige que ambas as tabelas estejam ordenadas pela chave de junção. Se os dados já vêm ordenados — ou se você tem índices que cobrem essa ordem — o merge join é eficiente e previsível. Senão, o banco precisa fazer um sort antes, e o custo do sort pode ser maior que o próprio JOIN. A dica prática aqui é olhar o plano de execução. Expanda o plano visual no seu cliente SQL e verifique qual algoritmo está sendo usado. Se for nested loop com uma tabela grande sem índice, crie o índice. Se for hash join com spill, aumente o work_mem ou reduza o cardinalese com filtros mais precisos.
Armadilhas que todo mundo cai
Um dos erros mais comuns é usar JOIN quando um EXISTS ou um IN faria o mesmo trabalho com menos overhead. Se você só precisa verificar se existe correspondência e não quer dados da outra tabela, trazer colunas extras é desperdício. O otimizador às vezes se perde com SELECT * em múltiplos JOINs e gera planos piores do que o necessário. Outro problema recorrente é junção entre colunas de tipos diferentes. Comparar um VARCHAR com um INT parece funcionar em alguns bancos, mas o cast implícito quebra índices. O otimizador não consegue usar o índice da coluna porque precisa converter cada valor na hora da comparação. Eu vi uma consulta que levava 30 segundos virar 2 segundos depois de mudar a coluna para o tipo correto. Só isso. Quando você junta três tabelas ou mais, o resultado pode crescer exponencialmente se houver multiplicidade nas chaves. Uma linha na tabela A pode ter dez correspondências em B, e cada uma dessas dez pode ter cinco em C. O resultado são cinquenta linhas para cada original. Isso se chama produto cartesico interno e não tem nada a ver com um CROSS JOIN proposital. É o JOIN que parece certo mas multiplica dados silenciosamente.
Para identificar isso, conte as linhas antes e depois de cada junção individual. Se a quantidade subir de forma desproporcional ao esperado, há duplicidade nas chaves de relacionamento. A solução normalmente envolve DISTINCT, GROUP BY, ou revisar o modelo para entender por que a relação não é um para muitos como você pensava.

Quando junção não é a resposta
Existem cenários onde JOIN é a ferramenta errada. Se você está tentando agregar dados de tabelas enormes só para fazer uma conta simples, talvez uma subconsulta ou uma CTE seja mais legível e performática. Junções aninhadas demais ficam difíceis de ler e ainda mais difíceis de otimizar. O banco também tende a gerar planos piores com Many-to-Many JOINs encadeados. Se o volume de dados é muito grande e as junções estão matando a performance, considere materializar resultados em tabelas intermediárias ou usar partições. Às vezes, pré-agrupar os dados antes de juntar reduz o cardinalese de forma significativa. Eu fiz uma migração de uma consulta que rodava 12 minutos para 45 segundos usando essa abordagem em um data warehouse. Há também o caso dos dados esparsos. Se uma coluna da tabela relacionada é quase sempre NULL, o JOIN pode estar trazendo informações irrelevantes que apenas aumentam o plano de execução sem agregar valor. Nesses casos, filtros adicionais ou junções condicionais com CASE podem reduzir o custo sem alterar o resultado final.
Junção é fundamental em bancos relacionacionais, mas o conhecimento teórico não substitui a leitura do plano de execução. Todo join que você escreve passa por decisões do otimizador que nem sempre são óbvias. Verificar o plano, testar com dados reais e observar o comportamento em carga é o que separa quem usa JOIN de quem controla JOIN. O resto é tentativa e erro, e ninguém quer passar horas debugando uma consulta que deveria ser simples.
Galeria
-
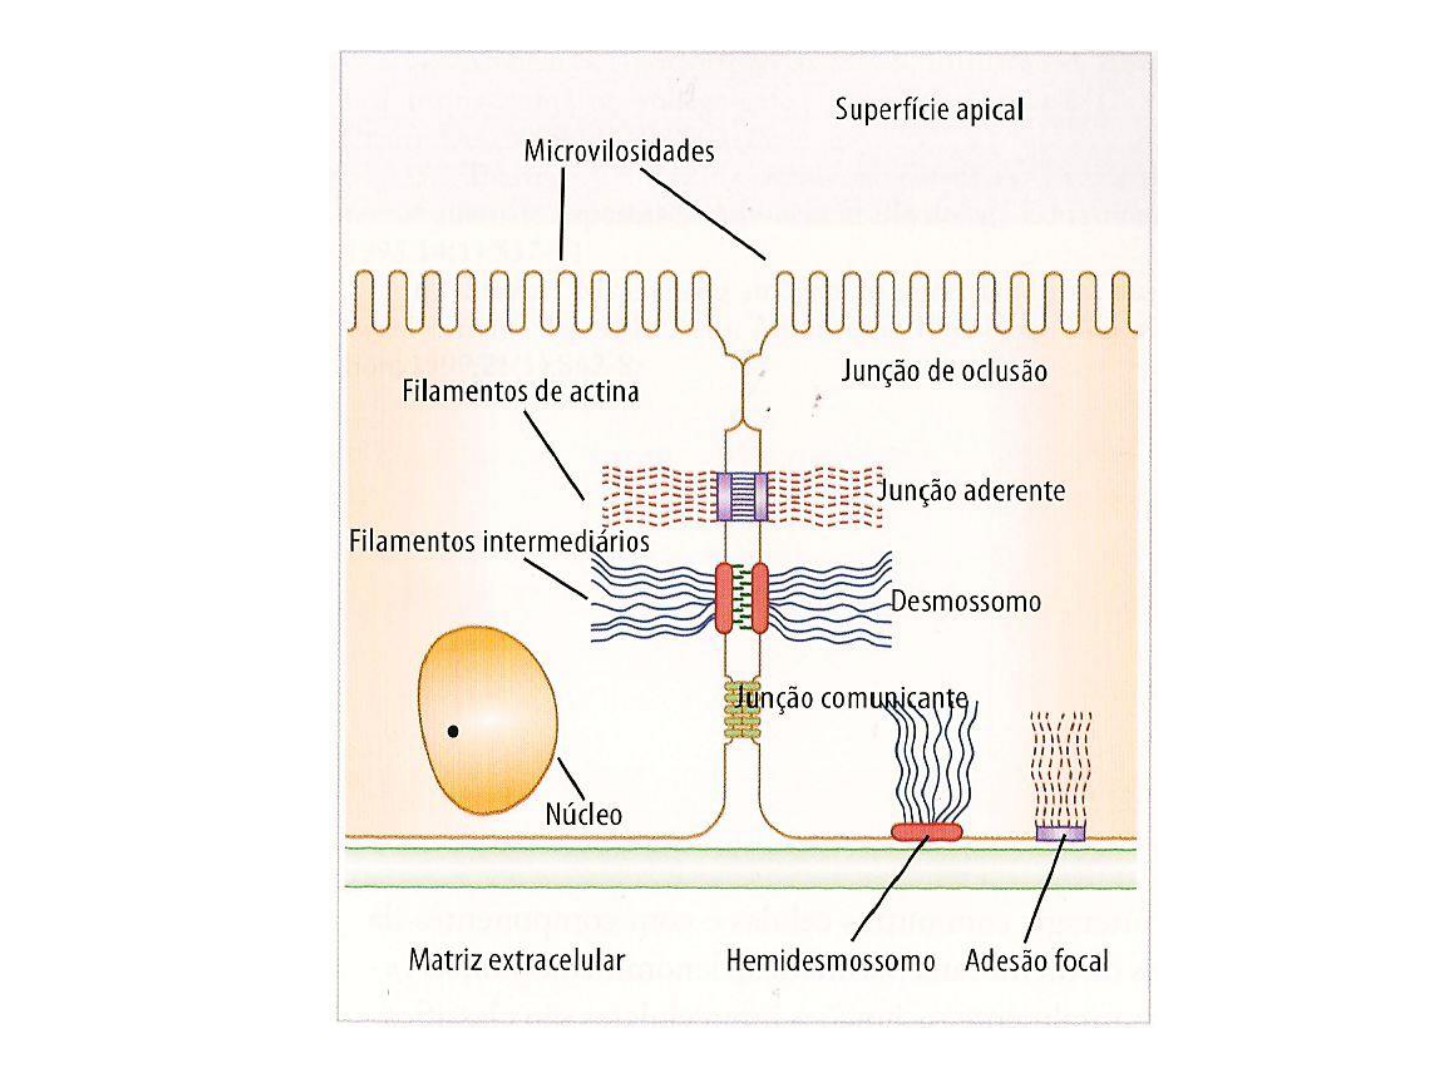
Juncao Comunicante Membranas Plasmáticas Biologia Celular -

Juncao Comunicante Membranas Plasmáticas Biologia Celular -

Sinônimos de Junção [por sentido] - Sinoscópio
