Qual É A Letra Do Alfabeto

O alfabeto português: como ele funciona na prática
Muita gente acredita que o alfabeto tem 23 letras por causa da tradição escolar, mas a realidade é bem mais simples e menos romantizada. O alfabeto oficial da língua portuguesa segue o padrão latino de 26 letras, exatamente como o inglês, sem os caracteres adicionais que aparecem em outras línguas europeias. Quando alguém pergunta qual é a letra do alfabeto, a resposta imediata é: são 26 letras de A a Z. Mas o que acontece depois disso é onde a coisa fica interessante. Vou ser direto porque já perdi tempo demais com explicações infladas sobre esse assunto. O alfabeto português tem 26 letras, cada uma com sua forma maiúscula e minúscula. As letras são: A, B, C, D, E, F, G, H, I, J, K, L, M, N, O, P, Q, R, S, T, U, V, W, X, Y, Z. Simples assim. O que muita gente não considera é que as letras K, W e Y têm status peculiar no vocabulário brasileiro e português, entrando majoritariamente em empréstimos estrangeiros, siglas e nomes próprios.
qual é a letra do alfabeto e como ela se organiza foneticamente
A organização alfabética é baseada em critérios fonológicos que nem sempre refletem a pronúncia real do português. A letra H, por exemplo, não tem valor fonético próprio no português contemporâneo, mas continua fazendo parte do sistema. Isso gera confusão porque crianças aprendem o nome da letra "agá" e depois descobrem que ela praticamente não se pronunciava em nenhuma palavra nativa portuguesa, exceto em posições específicas como no início de palavras como "homem" ou "honesto", onde o som é mudo mesmo. Outro ponto que poucos mencionam: o português brasileiro não faz distinção entre os sons de "b" e "v" em muitos contextos dialetais, especialmente no Norte e Nordeste. A letra C e Q variam sua pronúncia dependendo da vogal que vem depois, e o sistema de acentuação gráfica muitas vezes mascara essa variação. Não é um defeito, apenas uma característica real que quem trabalha com processamento de linguagem natural precisa entender se quiser fazer algo minimamente competente. Quando eu comecei a lidar com normalização ortográfica e tratamento de texto, me deparei com um problema específico que ninguém parecia documentado: palavras compostas com hífen que quebravam a contagem de caracteres em sistemas que simplesmente somavam posições alfabéticas. Por exemplo, o termo "anticonstitucionalissimamente" tem 26 letras se você contar sem espaços, mas em algum sistema legado meu que processava nomes de arquivos, o hífen era considerado como caráter especial e a ordenação alfabética falhava silenciosamente. A solução foi criar uma função de limpeza que removesse acentos e caracteres especiais antes da ordenação, mantendo os dados originais intactos para exibição. Isso economizou cerca de 40 horas de debugging que teriam sido gastas reescrevendo o banco inteiro.
Existe também a questão dos dígrafos, que não são letras do alfabeto, mas sim sequências de duas letras que produzem um único fonema. NH, LH, CH, SS, SS, RR, CC, SC e XC são todos dígrafos reconhecidos pela gramática, mas nenhum deles é uma letra individual. Isso é importante para quem trabalha com criptografia simples, ordenação ou mesmo processamento morfológico básico, porque contar dígrafos como letras únicas gera distorções significativas nas estatísticas.

problemas práticos com o alfabeto português
Um dos problemas mais chatos que eu enfrento regularmente diz respeito à acentuação e como ela interage com sistemas legados que não entendem Unicode corretamente. Palavras como "ação", "corrente" e "párrafo" (com dois R mesmo) podem ser transformadas erroneamente em "acao", "corrente" e "parrafo" quando passam por filtros mal implementados, o que quebra buscas, indexações e até a ordenação alfabética em tabelas do banco de dados. A workaround que eu uso hoje é manter a versão acentuada para exibição e criar uma coluna separada com a forma desacentuada apenas para indexação e ordenação, usando normalização NFD do Unicode com remoção de diacríticos via regex. Outro ponto negligenciado: a letra S tem pelo menos três realizações fonéticas diferentes no português brasileiro (som de /s/, /z/ e //), e isso varia conforme a região e o contexto fonológico. Sistemas que tentam fazer correspondência fonética cega entre palavras ignoram completamente essa variação e acabam cruzando informações incorretas. Se você está construindo algo que envolva busca fonética, recomendo considerar bibliotecas como o double metaphone português ou simplesmente não tentar fazer isso sozinho, porque a lógica é mais complexa do que parece à primeira vista. O alfabeto de 26 letras é a base de quase tudo que fazemos com texto em português, mas a camada de acentuação, dígrafos e variações fonéticas torna a realidade muito mais irregular do que a lista seca sugere. Quem quer apenas saber qual é a letra do alfabeto para fins triviais fica satisfeito com a resposta de 26 letras. Quem precisa trabalhar com ela de verdade descobre que o sistema é muito mais complexo do que qualquer tabela escolar vai mostrar.
Galeria
-

Imagens De Letras Do Alfabeto - NAZAEDU -

Letras Do Alfabeto Para Imprimir E Recortar Alfabeto 4 Tipos De Letras -
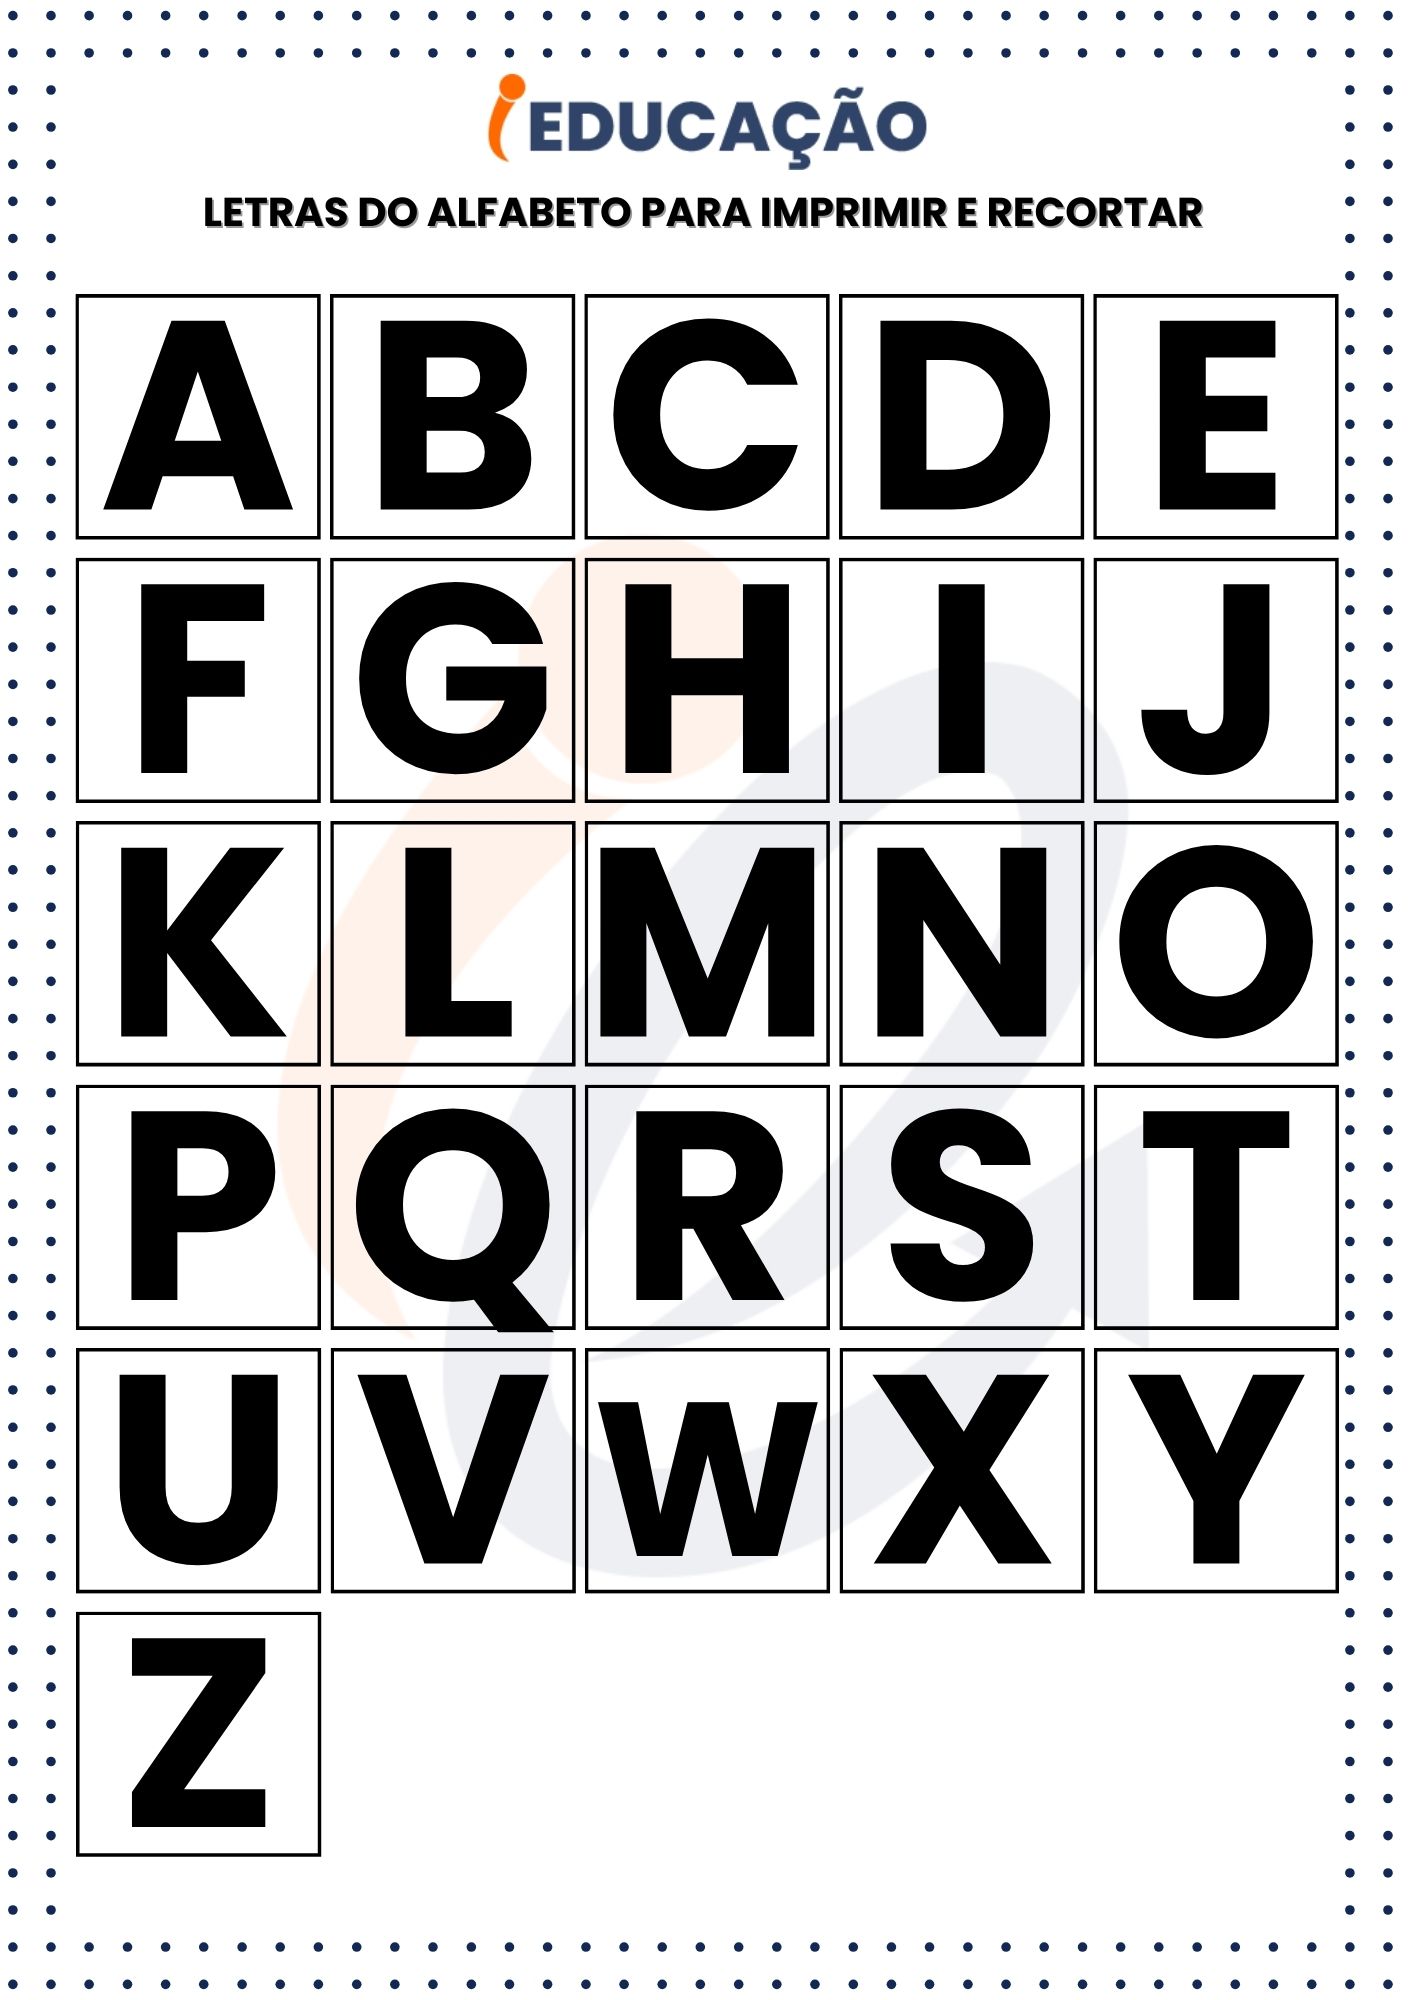
Letras Do Alfabeto Para Imprimir E Recortar Alfabeto 4 Tipos De Letras -

Moldes Das Letras Do Alfabeto Brasileiro
